Suno、音声と音楽を同時生成する新機能Speechをベータ公開
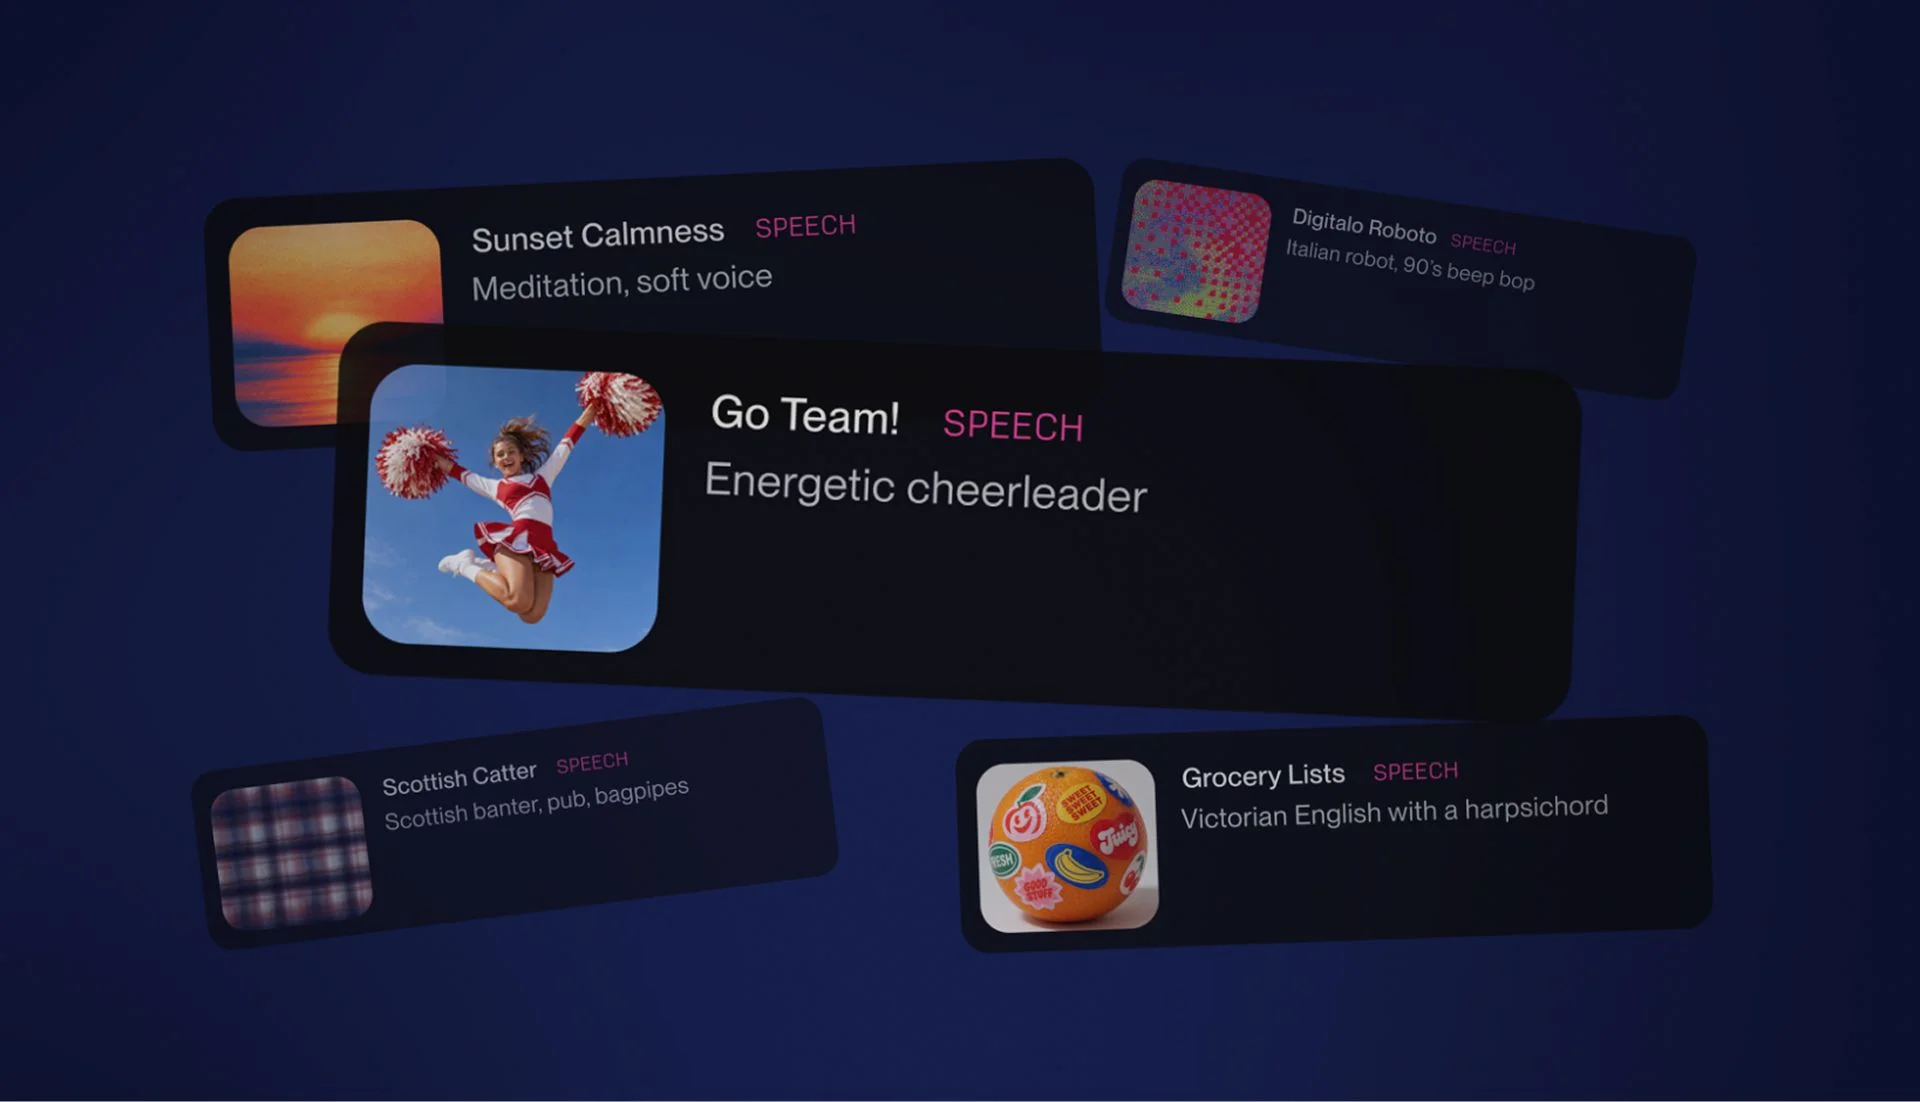
AI音楽生成のSunoが「Speech」ベータを公開。テキストから声と背景音楽を1つのトラックとして同時生成できる、同社初の音楽生成以外の製品。詩や子守唄などの用途を想定する。
AI音楽生成サービスのSunoが、音声と背景音楽を1つのトラックとして同時生成する新機能「Speech」のベータ版を公開した。最高商品責任者のJack Brodyが10月1日に発表したもので、音楽生成以外の分野に進出する同社初の製品となる。
声と音楽を1回の生成で統合
Speechの使い方は単純だ。ユーザーがアイデアや詩、自分で書いた文章をテキストで入力し、希望する声のスタイルと音楽のスタイルを指定すると、両者が溶け合った単一のオーディオトラックが出力される。背景音楽はオプションで、音声のみに切り替えるトグルも用意されている。
入力モードは2種類ある。シンプルモードは「船長が仲間を鼓舞するスピーチ」のような短い指示文を書くだけで生成できる。アドバンスドモードでは自分で原稿を用意し、声の性別や話し方のスタイル、生成ごとのばらつきの大きさまで細かく設定できる。生成できる長さは最大8分程度だ。
想定用途と既知の不具合
Sunoは詩の朗読、瞑想音声、子守唄、誕生日や結婚式向けのメッセージなど、個人的で意味のあるオーディオコンテンツの制作を主な用途として想定している。ASMR風の読み上げなど、ユーザーの創意次第で応用範囲は広がる。
一方でベータ版には既知の不具合がある。公式は「ベータは本当にベータの意味だ」と述べ、イギリス英語のアクセントが時々オーストラリア英語に変わってしまう現象や、台詞の間(ポーズ)が過剰に長くなる場合があることを認めている。学習方法の詳細は公開されていない。Speechはウェブ版・モバイル版の両方で全ユーザーに開放されている。
著作権訴訟の渦中でのリリース
Speechの公開は、Sunoが主要レコード会社との著作権訴訟を抱える中での発表だ。ミュンヘンの裁判所は最近、Sunoの著作権侵害を認定し、フェアユースの主張を棄却したばかりである。Sunoは9月9日にWarner Music Group、BMG、Believeとのパートナーシップのもとでv6モデルを発表するなど、レーベル側とのライセンス関係構築も並行して進めている。
音楽生成からスポークンオーディオへの事業領域拡大は、Sunoが「作曲ツール」から「音声コンテンツ全般の生成プラットフォーム」への転換を図っていることを示す動きといえる。