Anthropic、AI研究開発の26%をClaudeがリードと発表 自己改善の加速度を初の定量化
Anthropicは2026年8月時点で、自社のAI研究開発作業の26%を人間監督下でClaudeが単独主導し、90%以上の作業でAIが人間と協働していると公表した。AIが自身の後継モデル開発を担う速度を測る初の指標だ。
Anthropicは、自社のAI研究開発(R&D)作業のうちどれだけをAIが担っているかを示す指標「R&D Automation Index」を公開した。2026年8月時点で、Claudeが人間の高レベルな指示のみを受けてエンドツーエンドでタスクを完了する「リード」段階の作業は全体の26%に達し、人間との緊密な協働を含めると90%以上の作業にAIが関与しているという。
測定の仕組みと急速な伸び
Anthropicは、Epoch AIが開発した自動化レベル(AL)の尺度を採用している。AI関与ゼロのAL0から、AIが完全に自律動作するAL5までの6段階で、社内のあらゆるAI研究開発タスクを分類・集計する仕組みだ。2026年2月時点でほぼゼロだった「リード」段階の比率は、わずか6カ月で26%まで急上昇した。同時期、研究・エンジニアリング業務にあたるエージェントは常時約3万体が稼働していたとAnthropicは明らかにしている。
コード生産性とタスク遂行能力の変化
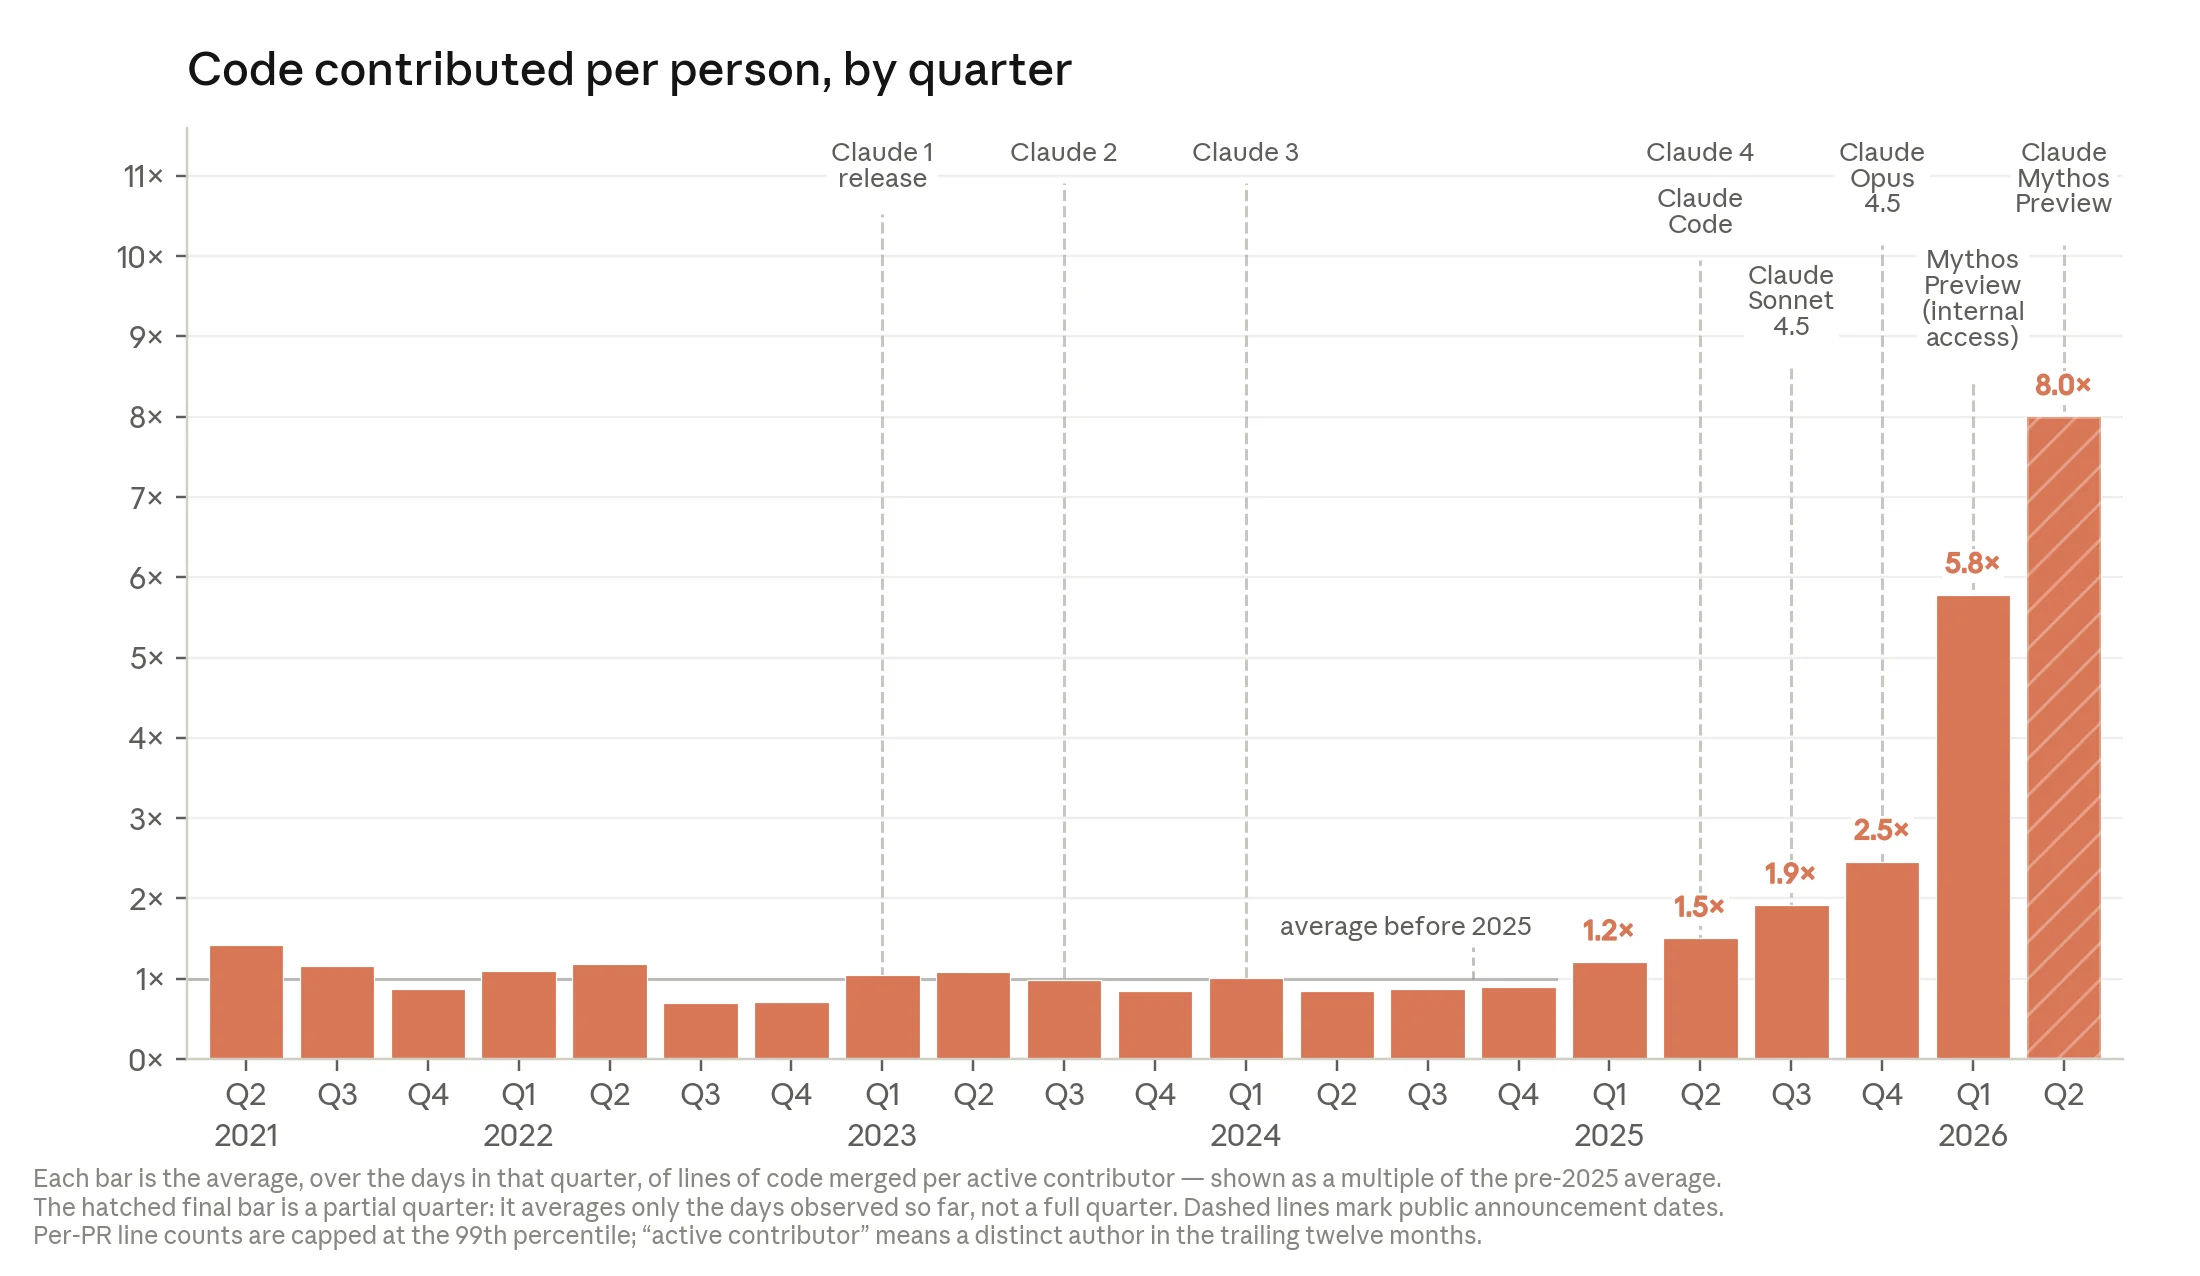
Anthropicの別の分析では、2026年5月時点で同社のコードベースに新規マージされるコードの80%以上をClaudeが生成しており、エンジニア1人あたりの1日のコード生産量は2024年比で8倍に増えたという。AIが信頼性高く単独でこなせるタスクの長さも、2024年3月の約4分から2025年3月の約90分、2026年3月には12時間以上へと、およそ4カ月ごとに倍増するペースで伸びている。オープンエンドな研究課題での成功率も、2025年11月の51%から2026年4月には76%まで上昇した。
業界への影響と透明性の呼びかけ
Anthropicはこの動きを「再帰的自己改善」、すなわちAIが自らの後継モデルの設計・開発を担う流れの前段階と位置づけ、業界全体に開発ペースの公開データ共有を求めている。開発速度が人間の監督能力を上回るリスクが指摘される中、AIが「今どこまで自社の開発を担っているか」を数値で示す試みは他の主要ラボにはまだない。ユーザーやエンジニアにとっては、Claude Codeなどの開発支援ツールの進化速度そのものが、今後さらに加速する可能性を示すデータといえる。
アップデート:「リード」の実態と数値の信頼性
THE DECODERの分析によれば、Anthropicが公表した「リード」(AL4)は完全自律を意味せず、Claudeが人間の指示に従いつつ問題に直面しても作業を止めず、最終判断は人間が下す段階にとどまる。完全自律を示すAL5には達していない。
数値の測定方法にも留意点がある。分類はClaude自身による自己採点であり、Anthropicの従業員が同じ作業を検証した結果、Claudeと同じレベルと判定した割合は約33%、一致率は59%にとどまった。また、常時稼働する約3万体のエージェントのうち、監視システムが介入して停止させた決定はわずか0.002%だった一方、Anthropicが安全性研究に割り当てているコンピュート資源は全体の6%にとどまるという。透明性を高める試み自体は評価できるものの、定義の曖昧さと自己採点への依存から、公表された数字は慎重に解釈する必要がある。
アップデート:OpenAI・xAIも自己改善の目標時期を公表
Anthropicに続き、OpenAIとxAIも「再帰的自己改善」に向けた独自の目標を明らかにした。OpenAIは、経験豊富な研究者が数日を要する作業をこなせる「自動研究インターン」の開発を公表し、サム・アルトマンCEOがかねて掲げていた2026年9月の目標を予定通り達成した。同社は2028年3月までに、より高度な「AI研究者」の実現を目指すとしている。xAIはGrokモデルの開発で人間の関与が段階的に減っていると報告し、2027年末までの完全自動化を目標に掲げる。一方Microsoftは無制限の自律性を追求しない「人間中心の超知能」路線を取ると表明しており、各社のスタンスには温度差がある。
UCサンタクルーズの物理学教授アンソニー・アギーレ氏は、完全な自律的自己改善について「人類史上最悪のアイデアだ」と警鐘を鳴らしている。SWE-benchやCORE-Benchといった主要ベンチマークが開発から数年以内に性能飽和に達している現状もあり、AIが自らを改善する速度に人間の監督・検証が追いつくかどうかが、業界共通の焦点になりつつある。